2026లో AI మరియు సంస్కృత పునరుజ్జీవనం: లాంగ్వేజ్ మోడల్స్, తాళపత్ర గ్రంథాల OCR, అనువాద సాధనాలు, AI ఇంకా ఎక్కడ తప్పు చేస్తోంది
సంస్కృతానికి ఇప్పుడు AI సమయం వచ్చింది: ఓపెన్ అనువాద మోడల్స్, 391,548 వాక్యాల శిక్షణ డేటాసెట్, చేతిరాత గుర్తింపు ఆధారంగా రూపొందిన జాతీయ తాళపత్ర గ్రంథ మిషన్, ఒక సంస్కృత విశ్వవిద్యాలయంలో AI బీటెక్, ప్రకటించిన రెండు సంస్కృత LLMలు. ఏవి నిజంగా ఉన్నాయి, ఏవి ప్రకటనలకే పరిమితం, AIకి సంస్కృతం ఇంకా ఎందుకు కష్టంగా ఉంది — ఇక్కడ తెలుసుకోండి.
సంస్కృతానికి ఇప్పుడు AI సమయం వచ్చింది: ఓపెన్ అనువాద మోడల్స్, 391,548 వాక్యాల శిక్షణ డేటాసెట్, చేతిరాత గుర్తింపు ఆధారంగా రూపొందిన జాతీయ తాళపత్ర గ్రంథ మిషన్, ఒక సంస్కృత విశ్వవిద్యాలయంలో AI బీటెక్, ప్రకటించిన రెండు సంస్కృత LLMలు. ఏవి నిజంగా ఉన్నాయి, ఏవి ప్రకటనలకే పరిమితం, AIకి సంస్కృతం ఇంకా ఎందుకు కష్టంగా ఉంది — ఇక్కడ తెలుసుకోండి.
సంక్షిప్త సమాధానం: 2026లో AI నిజంగానే సంస్కృతానికి సహాయపడుతోంది, ముఖ్యంగా మూడు రంగాల్లో: అనువాదం (IndicTrans2, ధర్మమిత్ర వంటి ఓపెన్ మోడల్స్, 391,548 జతల కొత్త శిక్షణ డేటాసెట్), పాఠ విశ్లేషణ (పద విభజన, ట్యాగింగ్ కోసం ByT5-Sanskrit) మరియు తాళపత్ర గ్రంథాలు (జ్ఞాన భారతం మిషన్ చేస్తున్న AI, చేతిరాత గుర్తింపు పని). ఈ సంవత్సరం రెండు సంస్కృత LLMలు ప్రారంభమయ్యాయి లేదా ప్రకటించబడ్డాయి. కానీ సంస్కృతం ఇప్పటికీ AIకి కష్టమైన భాషే, సులభం కాదు: బెంచ్మార్క్లు దీనిని తక్కువ-వనరుల భాషగా వర్గీకరిస్తున్నాయి, సమాసాలు, తాత్విక భావనల అనువాదానికి ఇంకా మనిషి పరిశీలన అవసరం.
ఆశ్చర్యపరిచే ఒక నిజం: సంస్కృతం, కంప్యూటర్ల గురించి బాగా ప్రచారంలో ఉన్న వాదన దాదాపు పూర్తిగా తలకిందులు. సంస్కృతం యొక్క పరిపూర్ణ వ్యాకరణం దాన్ని AIకి ఆదర్శంగా చేస్తుందని WhatsApp ఫార్వర్డ్లు చెబుతాయి. కానీ నిజంగా సంస్కృత AIని నిర్మిస్తున్న పరిశోధకులు దీనిని "రూపపరంగా సమృద్ధమైన" భాషగా, సహజ భాషా ప్రాసెసింగ్కు "అత్యంత సవాలుగా" ఉండే భాషగా వర్ణిస్తారు (మూలం: నెహర్డిచ్, హెల్విగ్ & కోయిట్జర్, ByT5-Sanskrit, 2024). AI మరియు సంస్కృతం అసలు కథ యంత్రాలకు సులభమైన భాష గురించి కాదు. ఒక శాస్త్రీయ భాషను మళ్లీ అందరికీ అందుబాటులోకి తేవడానికి పండితులు, ఇంజనీర్లు, సంస్థలు చేస్తున్న కష్టమైన కృషి గురించి.
ఉన్న సాధనాలు: మోడల్స్ మరియు డేటాసెట్లు
| సాధనం లేదా డేటాసెట్ | ఎవరు / ఎప్పుడు | ఇది ఏమి చేస్తుంది |
|---|---|---|
| IndicTrans2 | AI4Bharat; పత్రం మే 2023, లాంగ్-కాంటెక్స్ట్ వేరియంట్లు జనవరి 2025 | సంస్కృతంతో సహా మొత్తం 22 షెడ్యూల్డ్ భారతీయ భాషల మధ్య ఓపెన్-సోర్స్ అనువాదం |
| ByT5-Sanskrit | నెహర్డిచ్, హెల్విగ్, కోయిట్జర్; సెప్టెంబర్ 2024 | పద విభజన, లెమటైజేషన్, ట్యాగింగ్, వైదిక డిపెండెన్సీ పార్సింగ్, OCR తర్వాతి దిద్దుబాటు — అన్నింటికీ ఒకే మోడల్ |
| ధర్మమిత్ర (Dharmamitra) | UC బర్కిలీ (BAIR); ఆగస్టు 2024 | న్యూరల్ వ్యాకరణ విశ్లేషణ, సంస్కృతం నుంచి ఇంగ్లీష్ అనువాదం |
| మిత్రసంగ్రహ (Mitrasamgraha) | నెహర్డిచ్, కోయిట్జర్, పవన్ గోయల్ తదితరులు; జనవరి 2026 | అనువాద మోడల్స్ శిక్షణ కోసం 391,548 సంస్కృత-ఇంగ్లీష్ వాక్య జతలు |
| సంస్కృత హెరిటేజ్ ప్లాట్ఫామ్ | జెరార్డ్ హ్యూట్, ఇన్రియా (Inria) (హైదరాబాద్ విశ్వవిద్యాలయంలో మిర్రర్) | ఉచిత నిఘంటువులు, శబ్ద రూపాలు, ధాతు రూపాలు, వాక్యాలను విభజించి ట్యాగ్ చేసే సంస్కృత రీడర్ |
| సంసాధనీ (Samsaadhanii) | అంబా కులకర్ణి బృందం, హైదరాబాద్ విశ్వవిద్యాలయం | భారతీయ వ్యాకరణ సిద్ధాంతం ఆధారంగా సంస్కృతానికి కంప్యూటేషనల్ సాధనాలు |
IndicTrans2: AI4Bharat రూపొందించిన ఈ ఓపెన్-సోర్స్ మోడల్ మొత్తం 22 షెడ్యూల్డ్ భాషలలో సంస్కృతాన్నీ సపోర్ట్ చేస్తుంది. దీని పత్రం Transactions on Machine Learning Researchలో ప్రచురితమైంది; 1 డిసెంబర్ 2023న ఇండిక్-ఇండిక్ మోడల్, 18 జనవరి 2025న లాంగ్-కాంటెక్స్ట్ వేరియంట్లు జోడించబడ్డాయి (మూలం: AI4Bharat, IndicTrans2 GitHub).
ByT5-Sanskrit: పద విభజన, లెమటైజేషన్, మార్ఫోసింటాక్టిక్ ట్యాగింగ్, వైదిక డిపెండెన్సీ పార్సింగ్, OCR తర్వాతి దిద్దుబాటులో అత్యుత్తమ లేదా దాదాపు అత్యుత్తమ ఫలితాలను నివేదించిన ఒకే బైట్-లెవల్ మోడల్. ఇది Findings of EMNLP 2024లో ప్రచురితమైంది (మూలం: arXiv:2409.13920).
ధర్మమిత్ర: ఆగస్టు 2024లో ప్రకటించబడిన ఇది, Digital Corpus of Sanskrit వ్యాఖ్యానాలపై శిక్షణ పొందిన పద విభజన, లెమటైజేషన్, ట్యాగింగ్తో పాటు సంస్కృతం నుంచి ఇంగ్లీష్ అనువాదం అందిస్తుంది. దీనికి బర్కిలీ AI రీసెర్చ్లో సెబాస్టియన్ నెహర్డిచ్, కర్ట్ కోయిట్జర్ నాయకత్వం వహిస్తున్నారు (మూలం: INDOLOGY జాబితా, 28 ఆగస్టు 2024).
మిత్రసంగ్రహ: జనవరి 2026లో విడుదలైన ఈ శాస్త్రీయ సంస్కృత-ఇంగ్లీష్ డేటాసెట్ ఇంతకు ముందు అతిపెద్దదైన ఇతిహాస (Itihasa) కంటే నాలుగు రెట్లకు పైగా పెద్దది. దీనిపై NLLB, Gemma మోడల్స్ను ఫైన్-ట్యూన్ చేస్తే అనువాదం మెరుగవుతుంది (మూలం: arXiv:2601.07314).
దీర్ఘకాలంగా ఉన్న ఉచిత సాధనాలు: హ్యూట్ యొక్క సంస్కృత హెరిటేజ్ ప్లాట్ఫామ్ 2012లో ఓపెన్-సోర్స్ సాఫ్ట్వేర్గా విడుదలైంది (మూలం: సంస్కృత హెరిటేజ్ సైట్, హైదరాబాద్ విశ్వవిద్యాలయ మిర్రర్), అంబా కులకర్ణి బృందం హైదరాబాద్ విశ్వవిద్యాలయంలో సంసాధనీని నిర్మించింది (మూలం: ధర్మమిత్ర, అంబా కులకర్ణి ప్రొఫైల్).
తాళపత్ర గ్రంథాలు: OCR మరియు జ్ఞాన భారతం మిషన్
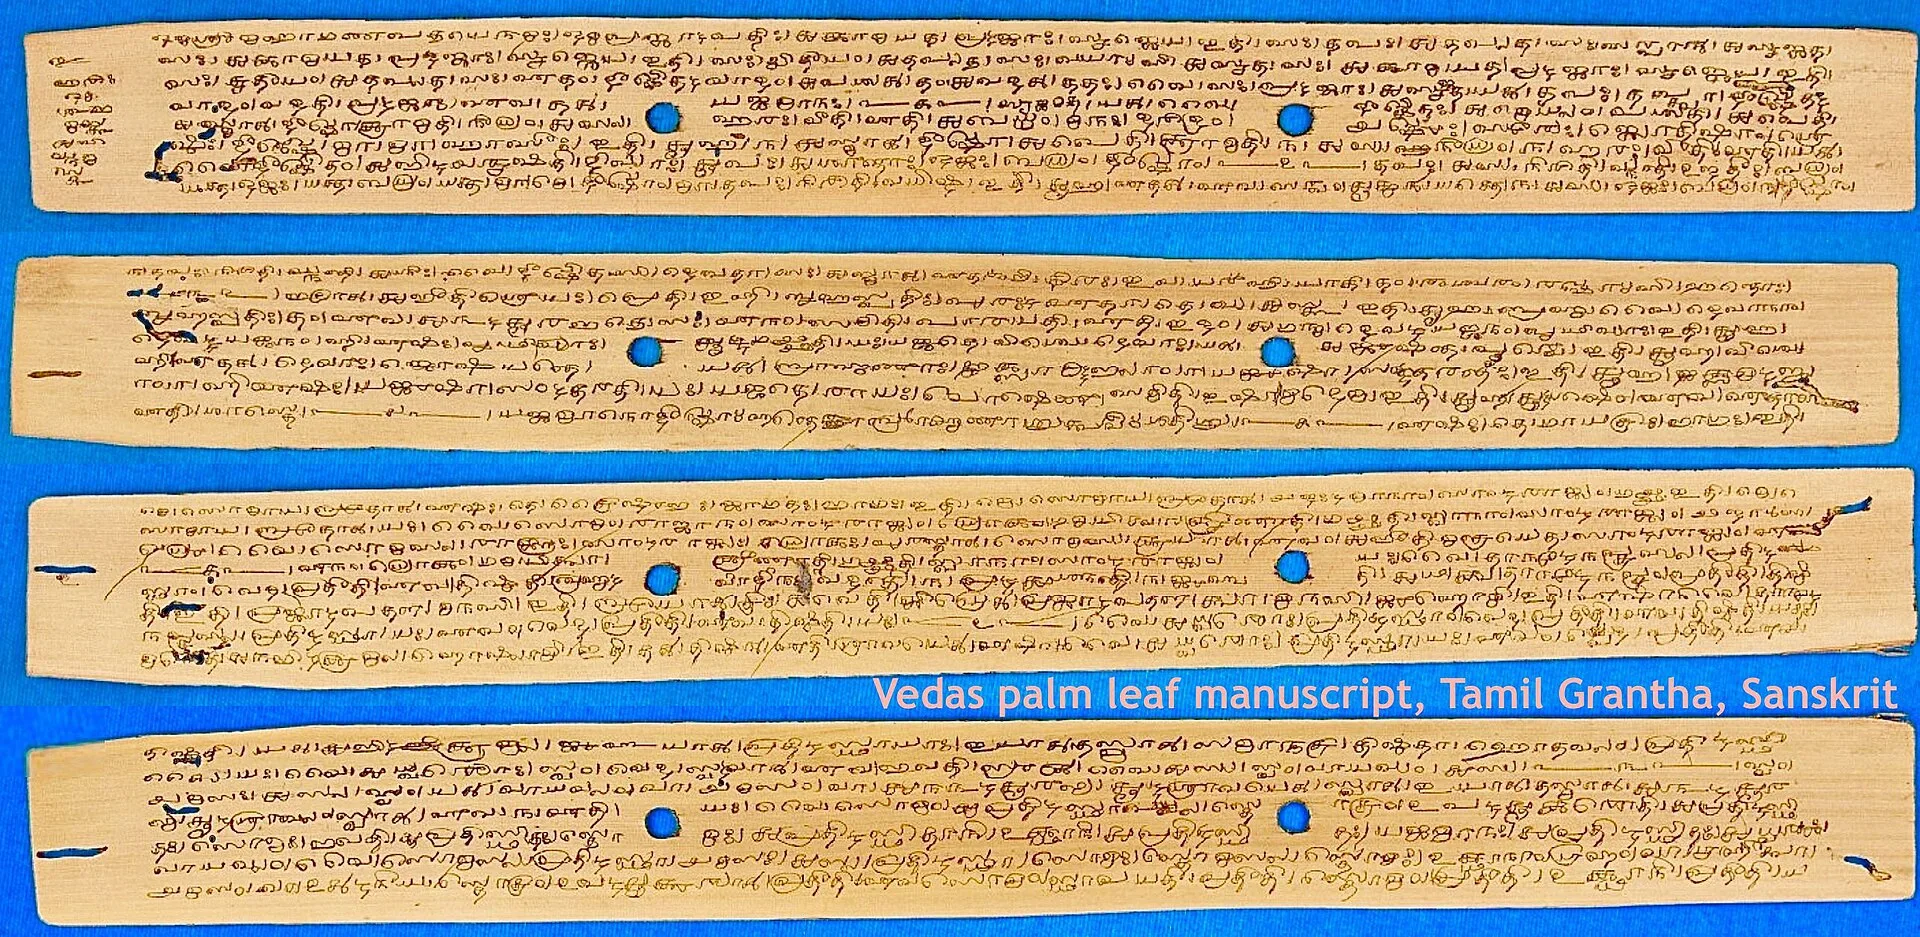
భారతదేశపు అతిపెద్ద ప్రయత్నం చాట్బాట్ల గురించి కాదు, తాళపత్ర గ్రంథాల గురించి. జ్ఞాన భారతం మిషన్కు 2024-31 కాలానికి Rs 482.85 కోట్ల వ్యయం కేటాయించబడింది, ఇందులో AI మరియు చేతిరాత గుర్తింపు ప్రధాన సాధనాలు. 10 సెప్టెంబర్ 2025 నాటి PIB నేపథ్య పత్రం ప్రకారం కృతి సంపద రిపోజిటరీలో ఇప్పటికే 44.07 లక్షల తాళపత్ర గ్రంథాలు నమోదయ్యాయి; అలాగే AI కేటలాగింగ్, OCR, లిపి గుర్తింపు, అనువాదాలను కవర్ చేసే జాతీయ AI ఇన్నోవేషన్ ఛాలెంజ్ అయిన జ్ఞాన-సేతును ప్రకటించింది. ఈ మిషన్ కేవలం సంస్కృతమే కాకుండా అనేక భాషలు, లిపులను కవర్ చేస్తుంది (మూలం: PIB, జ్ఞాన భారతం మిషన్ నేపథ్య పత్రం).
మొదటి జ్ఞాన భారతం అంతర్జాతీయ సదస్సు 11-13 సెప్టెంబర్ 2025న న్యూఢిల్లీ (New Delhi)లోని విజ్ఞాన్ భవన్లో జరిగింది, అక్కడ ప్రధాని మోదీ జ్ఞాన భారతం పోర్టల్ను ప్రారంభించారు. తాళపత్ర జ్ఞానాన్ని సంరక్షించడం, డిజిటలైజ్ చేయడం, పంచుకోవడంపై న్యూఢిల్లీ డిక్లరేషన్తో అది ముగిసింది; దాని సెషన్లు AI ఆధారిత చేతిరాత గుర్తింపు, లిపి పఠనాన్ని చర్చించాయి (మూలం: The Tribune, 14 సెప్టెంబర్ 2025).
2026: విశ్వవిద్యాలయాలు, LLMలు మరియు పరిశోధక సమాజం
- సంస్కృత హెరిటేజ్ మోడల్ (సెప్టెంబర్ 2026): ఆర్థిక మంత్రి నిర్మలా సీతారామన్ చెన్నై (Chennai)లోని మద్రాస్ సంస్కృత కళాశాలలో Articul8 AI రూపొందించిన ఈ సంస్కృత LLMను ప్రారంభించి, వ్యాకరణం, సంధి, సమాసాలను వివరించే, ప్రపంచవ్యాప్తంగా ఉన్న తాళపత్ర గ్రంథాలను సూచీకరించే AI సాధనాలు రావాలని పిలుపునిచ్చారు. మేము చూసిన మూలాల్లో దాని సామర్థ్యాలను స్వతంత్రంగా మూల్యాంకనం చేయలేదు (మూలం: DT Next, 16 సెప్టెంబర్ 2026). గమనిక: ఇది హ్యూట్ యొక్క పాత సంస్కృత హెరిటేజ్ ప్లాట్ఫామ్ కంటే భిన్నమైన ప్రాజెక్ట్.
- ఒక 'స్వదేశీ' సంస్కృత LLM (ప్రకటించిన ప్రణాళిక): జనవరి 2026లో MDS సంస్కృత కళాశాల, IIT మద్రాస్, కుప్పుస్వామి శాస్త్రి పరిశోధనా సంస్థ భాగస్వామ్యంతో ఒక ప్రాజెక్ట్ నివేదించబడింది; ఇది పాణినీయ వ్యాకరణం ఆధారంగా 110,000కు పైగా తాళపత్ర గ్రంథాలను ప్రాసెస్ చేయాలని లక్ష్యంగా పెట్టుకుంది. IIT మద్రాస్ నుంచి అధికారిక ప్రకటన, బెంచ్మార్క్ లేదా విడుదల ఏదీ కనిపించలేదు (మూలం: Organiser, 30 జనవరి 2026).
- సంస్కృత విశ్వవిద్యాలయంలో AI బీటెక్: కేంద్రీయ సంస్కృత విశ్వవిద్యాలయానికి తన నాసిక్ క్యాంపస్లో 2026-27 నుంచి AI మరియు డేటా సైన్స్లో బీటెక్ కోసం AICTE ఆమోదం లభించింది; JEE ద్వారా 60 సీట్లు, AI, NLP, కంప్యూటేషనల్ లింగ్విస్టిక్స్ను సంస్కృత వ్యాకరణం, తత్వశాస్త్రంతో కలిపి బోధిస్తారు (మూలం: The Tribune, 29 మే 2026).
- ISCLS సదస్సులు: 7వ అంతర్జాతీయ సంస్కృత కంప్యూటేషనల్ లింగ్విస్టిక్స్ సింపోజియం 15-17 ఫిబ్రవరి 2024న ఆరోవిల్ (Auroville)లో జరిగింది (10 పూర్తి పత్రాలు, 18 ప్రదర్శనలు), 8వది 9-11 మార్చి 2026న IIT రూర్కీలో జరిగింది; యంత్ర అనువాదం, ప్రసంగం, సంస్కృత కవితా సృష్టి వరకు అంశాలను చర్చించింది (మూలం: ACL Anthology, 7వ ISCLS; మూలం: ACL Anthology, 8వ ISCLS).
AIకి సంస్కృతం ఎందుకు కష్టం: ఒక ఉదాహరణ
రోజూ కనిపించే ఒక సంధి నియమాన్ని తీసుకుందాం. అ లేదా ఆతో ముగిసే పదం ఇ లేదా ఈతో మొదలయ్యే పదాన్ని కలిసినప్పుడు, ఆ రెండు అచ్చులు కలిసి ఏ అవుతాయి. పాణిని దీనిని సంప్రదాయంగా 6.1.87 అని సంఖ్య ఇచ్చిన "ఆద్ గుణః" అనే చిన్న సూత్రంలో చెప్పారు. కాబట్టి దేవ (దేవుడు) + ఇంద్ర = దేవేంద్ర.
ముందుకు వెళ్లడం సులభం: నియమాన్ని వర్తింపజేస్తే చాలు. వెనక్కి వెళ్లడం — ఒక గ్రంథాన్ని చదివే కంప్యూటర్ చేయాల్సింది అదే — కష్టం. దేవేంద్ర అనే పదం ఎదురైనప్పుడు, పద సరిహద్దు ఎక్కడ ఉందో, నాలుగు సాధ్యమైన అచ్చుల జతలలో (అ+ఇ, అ+ఈ, ఆ+ఇ, ఆ+ఈ) ఏది ఏను ఏర్పరిచిందో యంత్రం ఊహించాలి. దీన్ని ఒక పొడవైన సమాసంలోని ప్రతి సంధి జంక్షన్తో గుణించండి, అదే రూపం అనేక విభక్తులు కావచ్చనే విషయాన్ని కూడా జోడించండి — అప్పుడు పద విభజన దానికదే ఒక పరిశోధనా సమస్య ఎందుకో అర్థమవుతుంది. ByT5-Sanskrit, ధర్మమిత్ర సరిగ్గా ఈ పనిని పరిష్కరించడానికే నిర్మించబడ్డాయి.
డేటా రెండో సమస్య. IndicParam బెంచ్మార్క్ (నవంబర్ 2025) సంస్కృతాన్ని "అత్యంత తక్కువ-వనరుల" భాషలలో ఉంచింది; 11 భాషలపై 20 మోడల్స్లో అత్యుత్తమ సగటు ఖచ్చితత్వం కేవలం 58% మాత్రమే (Gemini-2.5). DharmaBench (IJCNLP-AACL 2025) కూడా సంస్కృతాన్ని తక్కువ-వనరుల చారిత్రక భాషగా పేర్కొంది (మూలం: మహేశ్వరి తదితరులు, IndicParam, arXiv:2512.00333).
అపోహ vs నిజం
| అపోహ | ఆధారాలు ఏమి చెబుతున్నాయి |
|---|---|
| కంప్యూటర్లకు సంస్కృతమే ఉత్తమ భాష అని NASA ప్రకటించింది. | ఈ వాదన రిక్ బ్రిగ్స్ 1985లో AI Magazineలో రాసిన పత్రం నుంచి వచ్చింది, అది సంస్కృత వైయాకరణుల పద్ధతులను AI నాలెడ్జ్ రిప్రజెంటేషన్తో పోల్చింది. అది అలాంటి వాదన చేయలేదు, అలాంటి NASA కార్యక్రమం ఏదీ లేదు. |
| సంస్కృతం 'కంప్యూటర్ సాఫ్ట్వేర్కు అత్యంత అనువైన భాష'. | బ్రిగ్స్ ఎప్పుడూ ఇలా చెప్పలేదు; దిలీప్ డిసూజా (Dilip D'Souza) ఈ మాటకు అసలు అర్థమే లేదని అంటారు. కంప్యూటర్లకు ఏ సహజ భాషా ఇవ్వలేని నిస్సందిగ్ధ సూచనలు అవసరం. తరచూ ఉదహరించే 1987 Forbes నివేదిక ఎక్కడా దొరకదు. |
| సంస్కృతపు ఖచ్చితమైన వ్యాకరణం దాన్ని AIకి సులభం చేస్తుంది. | సమృద్ధమైన రూపనిర్మాణం, సంధి, సమాసాలు దాన్ని కష్టతరం చేస్తాయి, డిజిటల్ శిక్షణ డేటా కూడా చాలా తక్కువ. |
| సంస్కృత AI అనువాద సమస్య ఇప్పుడు పరిష్కారమైపోయింది. | 2026 మిత్రసంగ్రహ అధ్యయనం ఇప్పటికీ క్లిష్టమైన సమాసాలు, తాత్విక భావనలు, బహుళ-స్థాయి రూపకాలతో తీవ్రమైన ఇబ్బందిని నివేదిస్తోంది. |
మూలాలు: మూలం: రిక్ బ్రిగ్స్, AI Magazine (1985); మూలం: Scroll.in (దిలీప్ డిసూజా); మూలం: ByT5-Sanskrit; మూలం: మిత్రసంగ్రహ. పూర్తి కథనాన్ని మా గైడ్లో చదవండి: NASA-సంస్కృత కంప్యూటర్ అపోహ.
విద్యార్థులు, NRI కుటుంబాలు సంస్కృతం కోసం AIని ఎలా వాడుకోవచ్చు
- విభజన, విశ్లేషణ కోసం AIని వాడండి: ఒక శ్లోక పంక్తి అర్థం కానప్పుడు, సంస్కృత హెరిటేజ్ రీడర్ లేదా ధర్మమిత్ర వంటి సెగ్మెంటర్ పదాలు ఎక్కడ విడిపోతాయో సూచించగలదు. ఆ ఫలితాన్ని ఒక సూచనగా మాత్రమే పరిగణించండి.
- అనువాదాలను ముసాయిదాలుగా చూడండి: యంత్ర అనువాదాన్ని ప్రచురిత అనువాదంతో పోల్చండి, ముఖ్యంగా శాస్త్రాలు, గ్రంథాల విషయంలో — అక్కడ పండితుల సమీక్ష తప్పనిసరి.
- వ్యాకరణం గురించి అడగండి, తర్వాత సరిచూసుకోండి: సాధారణ చాట్బాట్లు సంధి లేదా సమాసాన్ని వివరించగలవు, కానీ సంస్కృతంలో అవి తప్పులు చేస్తాయని బెంచ్మార్క్లు చూపిస్తున్నాయి. నిఘంటువుతో లేదా గురువుతో సరిచూసుకోండి.
- గురువును వదలకండి: ఉచ్చారణ, పఠనం, సందర్భానుసార అర్థం ఇప్పటికీ గురువు లేదా తరగతి ద్వారానే ఉత్తమంగా వస్తాయి. విదేశాల్లోని పిల్లల కోసం యాప్లు, ఆన్లైన్ కోర్సుల కోసం మా సంస్కృతం 2026 AI సాధనాలు, యాప్లు మరియు కోర్సుల గైడ్ చూడండి.
తరచుగా అడిగే ప్రశ్నలు
ఈ రోజే నేను వాడగలిగే సంస్కృత AI మోడల్ ఏదైనా ఉందా?
అనేక ఓపెన్ పరిశోధన సాధనాలు ఉన్నాయి. AI4Bharat రూపొందించిన IndicTrans2 మొత్తం 22 షెడ్యూల్డ్ భారతీయ భాషలలో సంస్కృతాన్నీ సపోర్ట్ చేస్తుంది, ByT5-Sanskrit పద విభజన, లెమటైజేషన్ వంటి పనులు చేస్తుంది, UC బర్కిలీ వారి ధర్మమిత్ర వ్యాకరణ విశ్లేషణ, సంస్కృతం నుంచి ఇంగ్లీష్ అనువాదం అందిస్తుంది. జెరార్డ్ హ్యూట్ రూపొందించిన సంస్కృత హెరిటేజ్ ప్లాట్ఫామ్ ఉచిత నిఘంటువులు, ఒక సంస్కృత రీడర్ అందిస్తుంది.
సంస్కృత వ్యాకరణం చాలా ఖచ్చితమైనది కాబట్టి AIకి సంస్కృతం సులభమా?
కాదు. పరిశోధకులు సంస్కృతాన్ని రూపపరంగా సమృద్ధమైన, NLPకి చాలా సవాలుగా ఉండే భాషగా వర్ణిస్తారు. సంధి, సమాసాల వల్ల పద విభజన, అనువాదం కష్టమవుతాయి; డిజిటల్ శిక్షణ డేటా చాలా తక్కువగా ఉండటం వల్ల 2025 బెంచ్మార్క్లు సంస్కృతాన్ని తక్కువ-వనరుల లేదా అత్యంత తక్కువ-వనరుల భాషగా వర్గీకరిస్తున్నాయి.
కంప్యూటర్లకు సంస్కృతమే ఉత్తమ భాష అని NASA చెప్పిందా?
లేదు. ఈ వాదన రిక్ బ్రిగ్స్ 1985లో AI Magazineలో రాసిన పత్రం నుంచి వచ్చింది, అది సంస్కృత వైయాకరణుల పద్ధతులను AI నాలెడ్జ్ రిప్రజెంటేషన్తో పోల్చింది. సాఫ్ట్వేర్కు సంస్కృతమే ఉత్తమ భాష అని అది చెప్పలేదు, అలాంటి NASA కార్యక్రమం ఏదీ లేదు.
గీత లేదా ఉపనిషత్తుల AI అనువాదాలను నమ్మవచ్చా?
వాటిని తుది ప్రమాణంగా కాకుండా మొదటి ముసాయిదాగా వాడండి. జనవరి 2026లో విడుదలైన అతిపెద్ద సంస్కృత-ఇంగ్లీష్ డేటాసెట్ కూడా క్లిష్టమైన సమాసాలు, తాత్విక భావనలు, పొరలు పొరలుగా ఉండే రూపకాలతో తీవ్రమైన ఇబ్బంది ఉందని నివేదిస్తోంది. ముఖ్యమైన భాగాలను పండితుల అనువాదంతో లేదా గురువుతో సరిచూసుకోండి.
జ్ఞాన భారతం మిషన్ అంటే ఏమిటి?
2024-31 కాలానికి Rs 482.85 కోట్ల వ్యయంతో, AI మరియు చేతిరాత గుర్తింపును ప్రధాన సాధనాలుగా ఉపయోగించే జాతీయ తాళపత్ర గ్రంథ మిషన్. సెప్టెంబర్ 2025 నాటికి కృతి సంపద రిపోజిటరీలో 44.07 లక్షల తాళపత్ర గ్రంథాలు నమోదయ్యాయి. ఇది కేవలం సంస్కృతమే కాకుండా అనేక భాషలు, లిపులలోని గ్రంథాలను కవర్ చేస్తుంది.
2026లో సంస్కృత LLMను ఎవరు ప్రారంభించారు?
సెప్టెంబర్ 2026లో ఆర్థిక మంత్రి నిర్మలా సీతారామన్ చెన్నైలోని మద్రాస్ సంస్కృత కళాశాలలో Articul8 AI రూపొందించిన సంస్కృత హెరిటేజ్ మోడల్ను ప్రారంభించారు. మేము చూసిన మూలాల్లో దాని సామర్థ్యాలను స్వతంత్రంగా మూల్యాంకనం చేయలేదు. IIT మద్రాస్ భాగస్వామ్యంతో ఒక ప్రత్యేక స్వదేశీ సంస్కృత LLM ప్రాజెక్ట్ జనవరి 2026లో ఒక ప్రణాళికగా మాత్రమే నివేదించబడింది.
సంబంధిత గైడ్లు
- సంస్కృతం 2026: NRI కుటుంబాల కోసం AI సాధనాలు, యాప్లు మరియు ఆన్లైన్ కోర్సులు
- పాణిని సంస్కృత వ్యాకరణం మరియు కంప్యూటర్ సైన్స్
- NASA-సంస్కృత కంప్యూటర్ అపోహ మరియు రిక్ బ్రిగ్స్ (1985)
- AI గీత చాట్బాట్లు: ఖచ్చితత్వం మరియు నైతికత
- మాధవుడు మరియు కేరళ పాఠశాల: పై కోసం అనంత శ్రేణులు
- హిందువుల కోసం క్వాంటమ్ కంప్యూటింగ్ వివరణ
సంపాదకుని గమనిక (9 అక్టోబర్ 2026)
ఈ పేజీలోని ప్రతి మోడల్, తేదీ, సంఖ్య, ఉల్లేఖనం పాఠంలో లింక్ చేసిన మూలాల నుంచే వచ్చాయి: arXiv మరియు ACL Anthologyలోని పరిశోధనా పత్రాలు, AI4Bharat రిపోజిటరీ, ప్రెస్ ఇన్ఫర్మేషన్ బ్యూరో, The Tribune, DT Next, Organiser నివేదికలు. IIT మద్రాస్తో ముడిపడిన సంస్కృత LLM వంటి కేవలం ప్రణాళికలుగా నివేదించబడిన అంశాలను అలాగే పేర్కొన్నాము, స్వతంత్రంగా మూల్యాంకనం చేయని ప్రారంభిత మోడల్స్ను గుర్తించాము. సంధి ఉదాహరణ పాణిని వ్యాకరణంలోని ఒక ప్రామాణిక నియమాన్ని వివరిస్తుంది. కొత్త సంస్కృత AI సాధనాలు విడుదలై, మూల్యాంకనం జరిగే కొద్దీ ఈ పేజీ నవీకరించబడుతుంది.
You might also like
కంప్యూటర్లకు సంస్కృతమే ఉత్తమ భాష అని నాసా (NASA) చెప్పిందా? రిక్ బ్రిగ్స్ 1985 పత్రం నిజానికి ఏం చెప్పింది
పాణిని మరియు కంప్యూటర్ సైన్స్: అష్టాధ్యాయి ఒక ఫార్మల్ నియమ వ్యవస్థలా ఎలా పనిచేస్తుంది, 'పాణిని-బాకస్ ఫార్మ్' కథ
రోబో పూజ చేయగలదా? రోబో హారతి, ఆచారాల్లో AI మరియు హిందూ సంప్రదాయం ఏమంటుంది